现在咨询,获得最前沿的AR产品
2026-09-25
Google Arts & Culture Lab在9月24日上线The Talking Museum。用户可以从190余件3D文化对象中按尺寸、材料或年代浏览,把对象放进虚拟研究室,360度旋转与缩放,点击热点,并借助Gemini收听讲解、继续提问。合作名单包括大英博物馆、凡尔赛宫、NASA、史密森学会多家博物馆、自然历史博物馆等。Google同日还发布Museum Memory,让用户记住虚拟展墙后复原画作位置。两者都在线可用,但官方把它们定义为实验,并明确生成式AI仍具实验性。
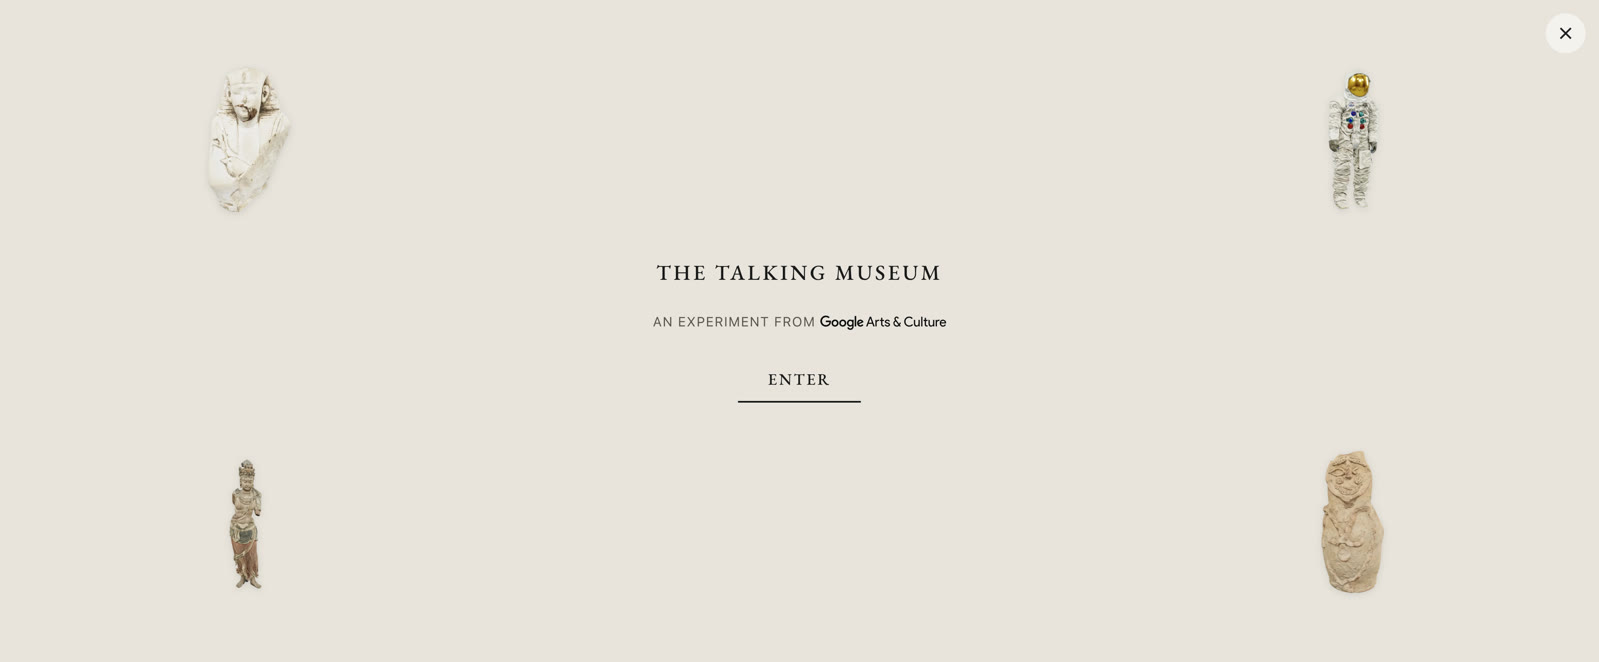
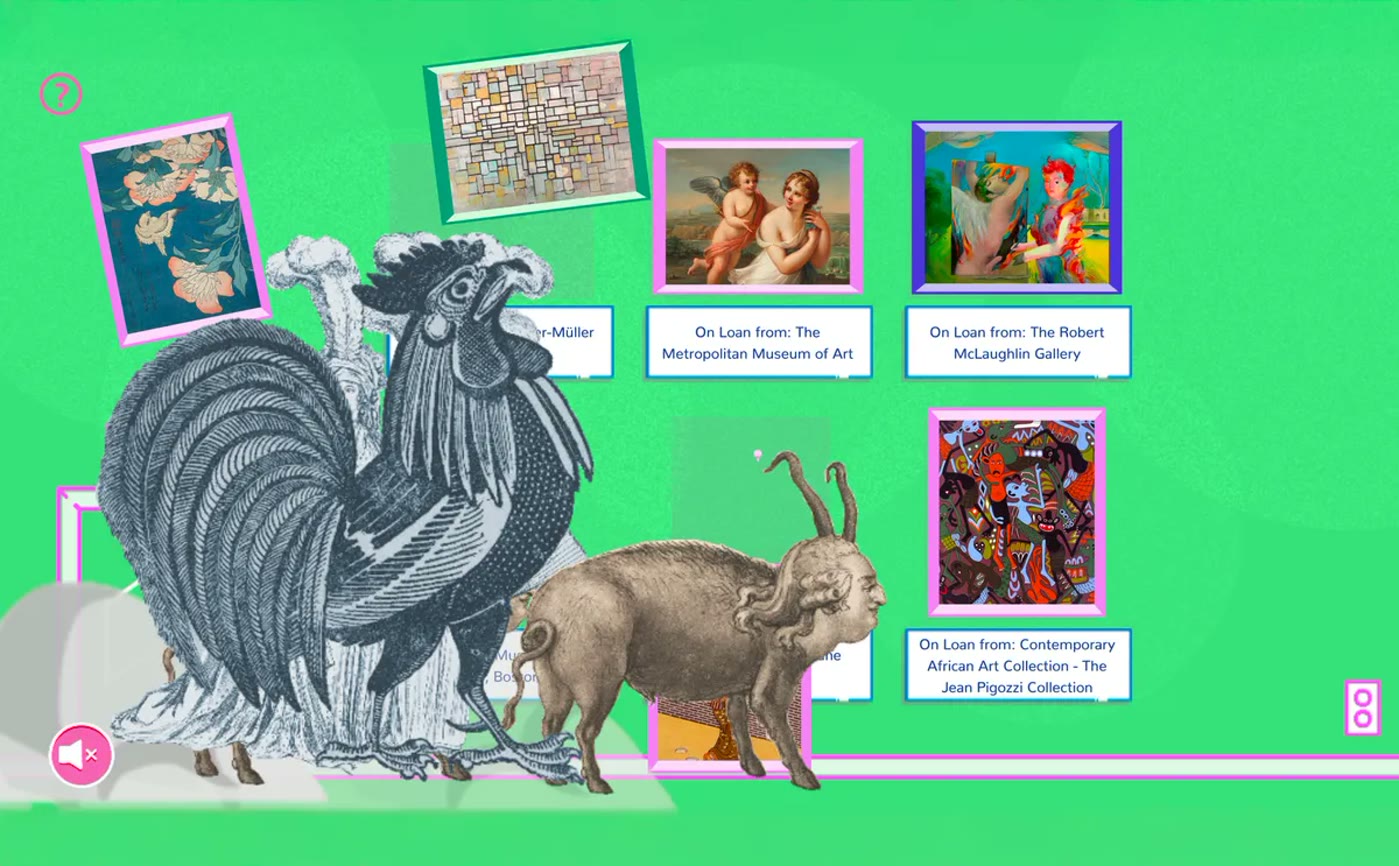
事件发生日期:2026-09-24在线实验正式上线;一手信源日期:Google官方博客与Google Arts & Culture实验页均标注2026-09-24。以下把原文事实、实施含义与未披露项分开。
| 公开字段 | 原文事实与边界 |
|---|---|
| 对象与操作 | 190余件3D文化对象,跨越史前至当代;可按尺寸、材料、年代浏览,并进行缩放、旋转、热点查看与问答。 |
| AI角色 | Gemini提供音频讲解与追问辅助;Google页面同时提示生成式AI具有实验性,不能把每个回答视为馆方定稿。 |
| 合作来源 | 官方实验页列出大英博物馆、凡尔赛宫、NASA、史密森学会、自然历史博物馆、柏林国家博物馆等多家合作方。 |
| 未披露边界 | 未公开问答准确率、答案审核和纠错流程、支持语种、数据保存、无障碍细节、单件文物授权范围与实体馆部署计划。 |
每件对象至少同时需要来源机构、名称、年代、材料、尺寸、3D资产和解释文本,部分还要配置热点。用户按材料和年代筛选,意味着元数据必须可比较;用户继续追问,意味着系统要在对象事实、馆方叙事和生成答案之间保留边界。项目页公开了合作机构名单,却没有逐件展示授权、审核和更新流程,因此不能由“来自博物馆”推断每一句AI回答都已获馆方逐字审核。
旋转让观众观察背面和底部,热点把注意力引向铭文、工艺或损伤,问答让不同基础的人继续追问。三者不应相互替代:没有清晰模型,热点只是悬空标签;没有经过策展的热点,用户不知道先看哪里;没有来源和不确定性说明,问答可能把推断说成事实。Museum Memory则证明数字藏品还可以进入“观察—记忆—复原”的任务,而不必都做成开放问答。
线上对象可以独立旋转,实体馆AR要面对真实展柜、光照、人群、视线和走动路线。数字模型必须对准展品或指定空间,热点要避免遮挡实物,音频不能互相干扰,错误回答还要有回到馆方讲解的入口。The Talking Museum目前是网页实验,官方没有说它已经进入实体馆AR眼镜或VPS导览,文章不把线上3D体验写成线下部署。
博物馆可先建立馆藏ID、来源、策展文本、3D资产、热点和版本,再决定哪些字段允许AI重组、哪些问题必须回到固定答案、哪些话题需要拒答或提示不确定。线下可用视+AR数字文旅方案组织路线与内容,以EasyAR Mega处理大空间定位,手机免下载入口则可参考EasyAR WebAR。这些是项目方法上的对照,本文没有Google与视+AR或EasyAR合作的证据。
不要只问“能否回答”。应准备策展事实题、对象细节题、超出资料题、争议题、儿童表达题和诱导错误题,分别记录引用来源、拒答、纠正、语音可懂度和响应时间。还要让馆员能看到热门问题、修订知识和下线错误内容。官方尚未披露The Talking Museum的这些后台与评测数据,因此本文只把功能和可见流程写成事实。
Google官方称有190余件3D文化对象,来自多家文化机构,跨度从史前到当代。
按尺寸、材料或年代浏览,选入虚拟研究室,旋转、缩放、看热点、听AI讲解并继续提问。
不能这样推断。Google明确提示生成式AI具有实验性,官方未公开逐条馆方审核机制。
不是。当前公开形态是在线实验,官方没有披露实体馆眼镜、VPS或现场运营部署。