现在咨询,获得最前沿的AR产品
2026-10-02
UC San Diego 9月30日发布的官方报道显示,孵化企业Aynak计划在假日前通过圣迭戈本地眼镜店分发约35副原型,第二批计划在2027年1月投放。眼镜使用小型视觉传感器判断佩戴者注视的说话者,框架内的定向麦克风采集不同方向声音,再由眼镜端AI实时增强目标人声。公司称图像不会离开眼镜;手机应用可按个人听力情况调整频段。该产品仍处于原型试用阶段。
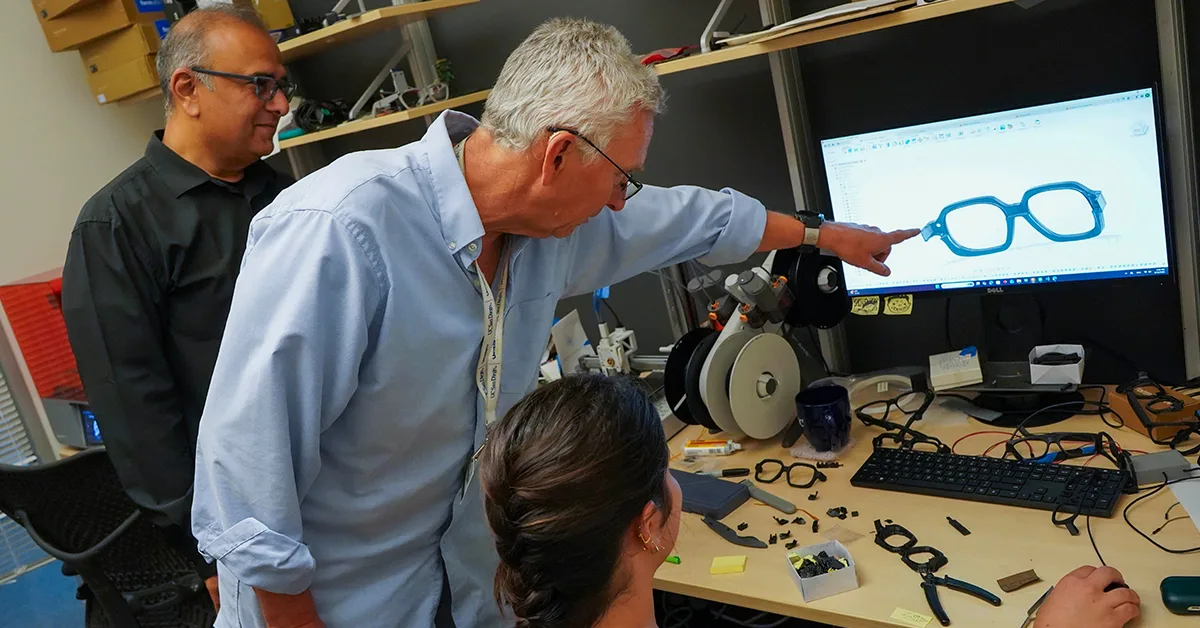
事件发生日期:2026-09-30公开原型分发计划;第二批计划2027-01投放;一手信源日期:UC San Diego Today 2026-09-30发布。以下把原文事实、实施含义与未披露项分开。
| 公开字段 | 原文事实与边界 |
|---|---|
| 试用规模 | 计划先分发约35副原型,渠道为圣迭戈本地眼镜店;第二批计划2027年1月。 |
| 团队与孵化 | 报道写明团队在UC San Diego Qualcomm Institute创新空间孵化,现有6名本地员工、2名美国远程成员及一个印度小团队。 |
| 技术链路 | 小型视觉传感器识别注视对象,定向麦克风采集声音,AI在眼镜端融合并增强目标语音。 |
| 延迟约束 | 官方报道强调处理必须在毫秒级完成,否则放大声与自然声的时间差会被听成回声。 |
| 未披露项 | 处理器、续航、重量、价格、试用设计、评价指标、临床证据、上市时间及具体监管分类均未公布。 |
传统助听方案主要从声音本身估计方向和目标,但餐厅、家庭聚会等多人环境里,说话者可能不断切换。眼镜天然知道头部朝向,视觉传感又能补充注视对象,于是系统可以把视觉上下文交给音频算法。这里的价值是目标选择,不是拍照;真正的验收问题是低光、遮挡、多人并排和快速转头时,系统是否仍能选对说话者。
佩戴者会同时听到空气中直接传播的声音和眼镜处理后的声音。若算法、缓存或无线链路太慢,两路声音错开就可能产生回声感。Aynak把处理放在眼镜端,是对这一物理约束的回应。后续测试应公布端到端延迟的测量条件,并分别验证安静室内、嘈杂餐厅、户外风噪和多说话者切换。
公司公开表述为图像不离开设备,但用户仍需要知道是否保存帧、是否生成身份特征、诊断日志包含什么、应用能否导出数据,以及旁观者如何知道传感器状态。最稳妥的设计是默认不存原始图像、只保留最小化的短时特征,并提供物理指示、权限开关与可审计删除。公开报道没有给出这些实现细节。
约35副原型更适合发现佩戴舒适、镜框适配、延迟、噪声场景和操作流程问题。它并不能自动证明听力改善、长期安全或适用于所有听损人群。美国FDA把助听器纳入医疗器械监管,并区分处方与符合条件的非处方产品;Aynak的具体监管路径尚未在报道中披露,因此不能把“试用”写成获批或上市。
同样使用摄像头和麦克风,不同场景的数据边界完全不同。视+AR AR眼镜应用方案可用于梳理感知、交互与业务流程,EasyAR Sense SDK适合评估视觉识别能力,开发者还应查看EasyAR开发文档中的设备与权限说明。本文没有证据表明Aynak采用这些产品。
第一,多少人能在首次佩戴时正确调节;第二,端到端延迟在不同噪声下是否稳定;第三,注视目标切换是否误判;第四,电池能否覆盖真实社交时段;第五,处方镜片、鼻托和两种镜框的适配情况;第六,用户能否理解数据处理与产品边界。只有这些结果公开后,才适合讨论规模化。
官方报道写明首批约35副,第二批计划在2027年1月投放。
公司称其目的是识别佩戴者正在注视的说话者,图像不离开眼镜;是否短时缓存等细节未披露。
报道指出处理延迟会让增强声与自然声形成回声,端侧计算有助于缩短链路。
公开报道没有说明监管批准或具体产品分类,应视为原型试用而非获批结论。