

为什么智能眼镜更难“听清”
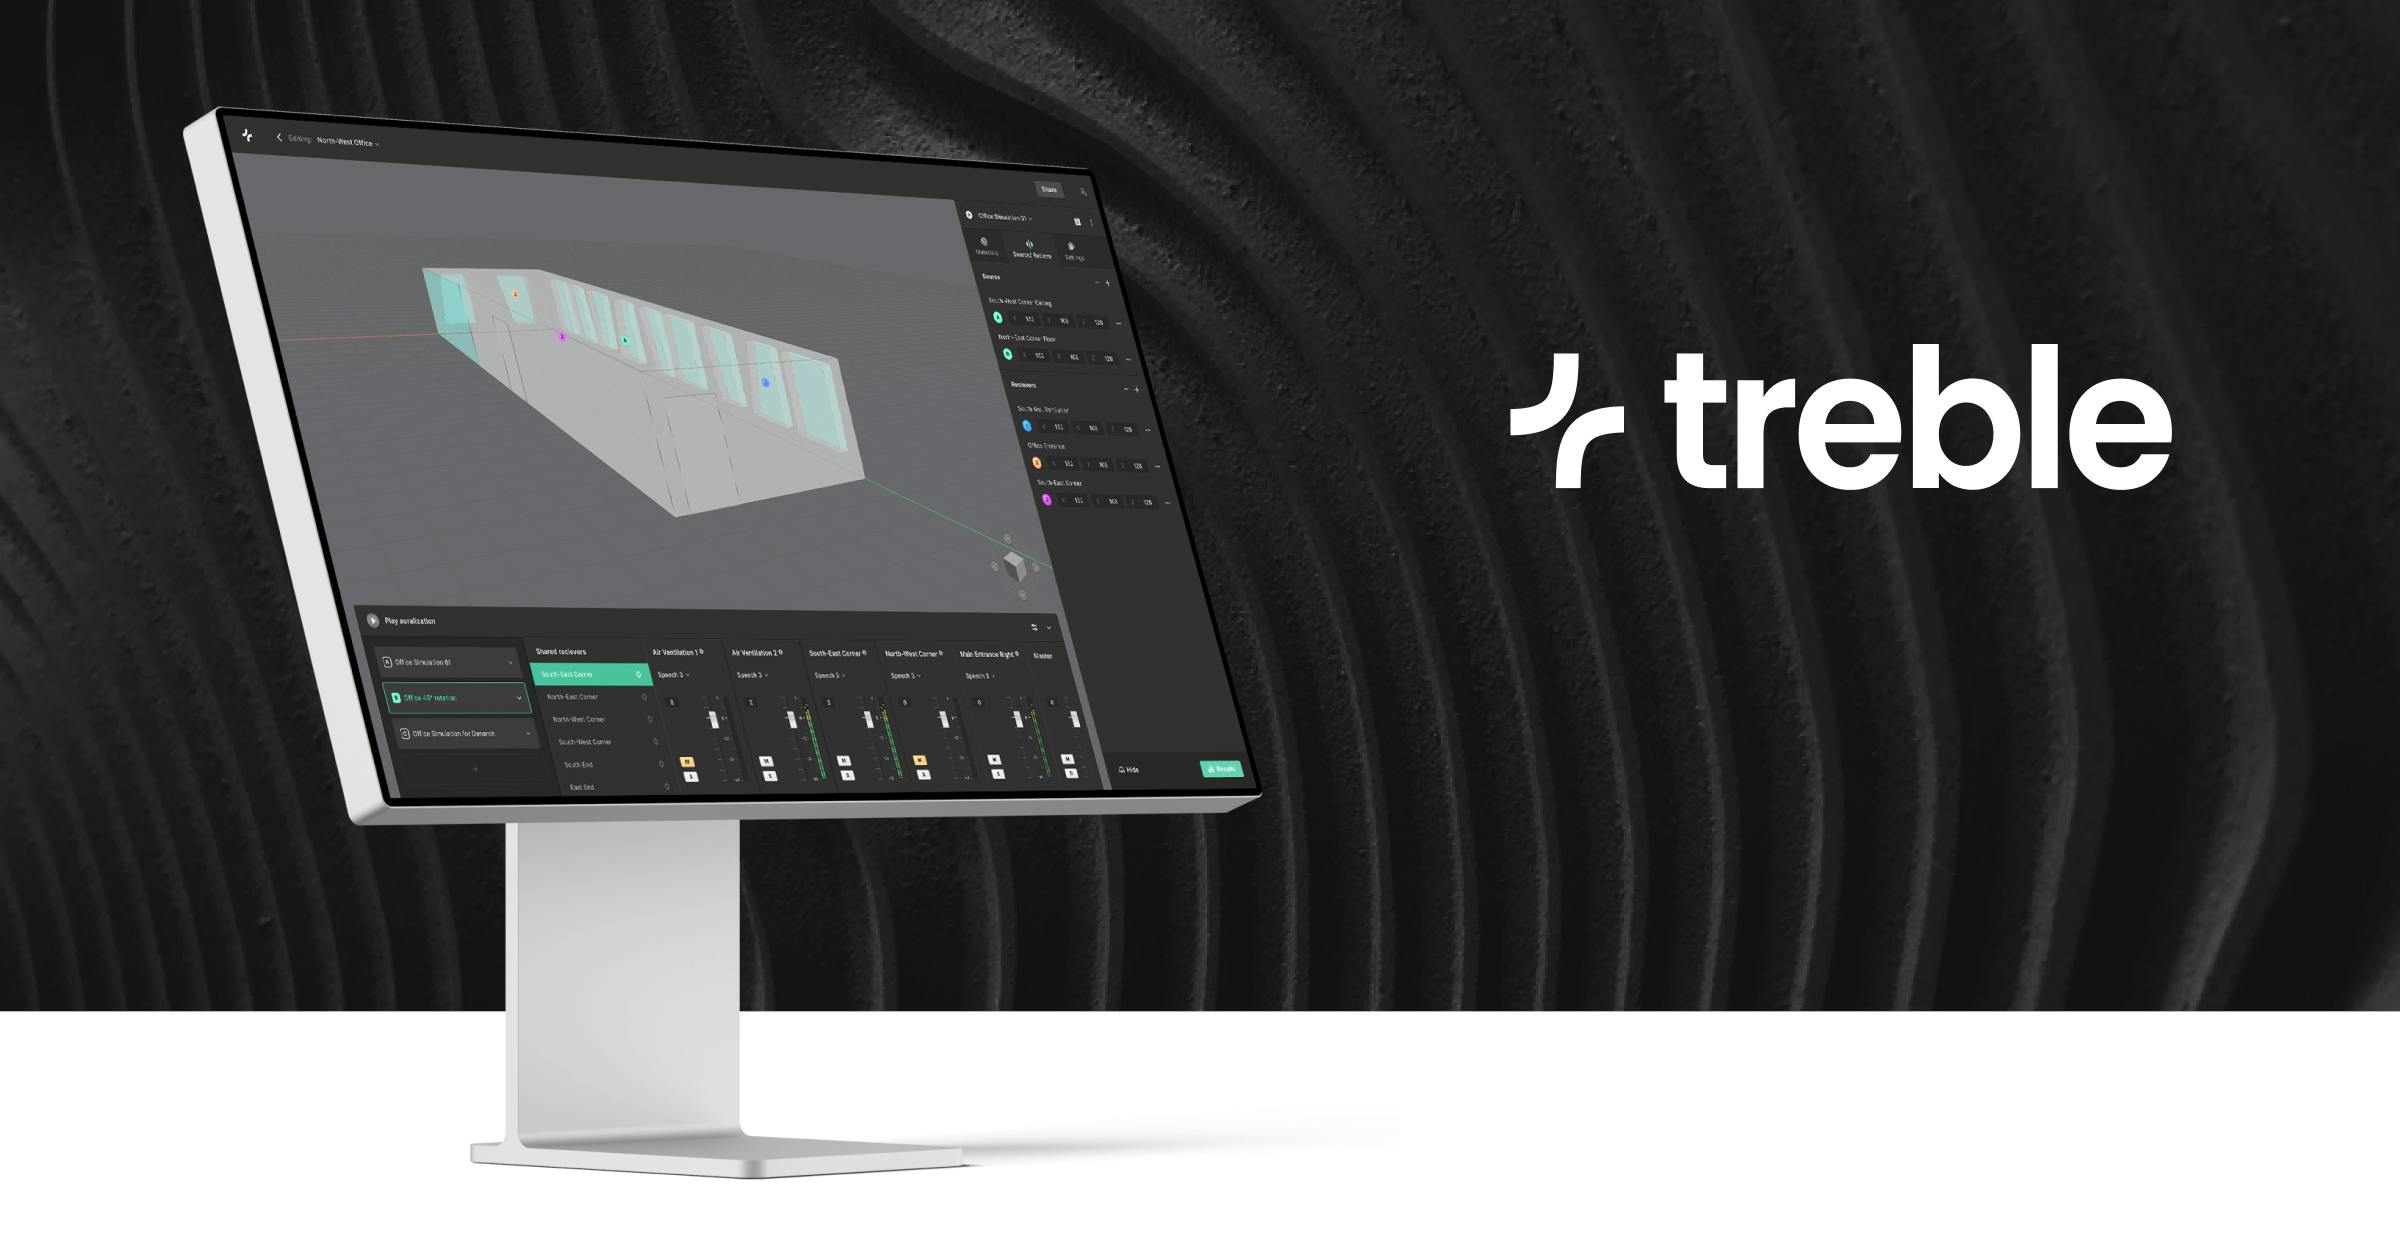
智能眼镜把麦克风放在头部附近,但真实使用环境远比实验室复杂:佩戴者在移动,镜框角度会变化,街道、展馆和会议室的混响不同,旁人的说话声、风噪和扬声器声音还会同时进入系统。10月28日,Treble Technologies与DSP Concepts公布一套端到端开发演示,围绕Treble 3.2声学智能平台和Audio Weaver实时音频基础设施,展示怎样在物理样机之外提前验证语音与音频表现。
这不是一次单点算法展示,而是把虚拟设备导入、佩戴建模、场景生成、合成数据和算法评估串成流程。对需要语音指令、实时字幕、翻译、远程协作的智能眼镜而言,语音链路能否在真实噪声中稳定工作,直接决定体验是否连贯。
四类变量可以在虚拟环境里组合
Treble公布的能力包括把自有设备模型安装到不同头型的虚拟人体上,改变眼镜贴合方式和朝向;模拟移动的佩戴者与声源;在不同房间中组合语音、噪声和混响;按目标信噪比批量生成场景;并支持一台设备上的多扬声器建模。
传统测试往往需要制作样机、布置声场并反复招募受试者。虚拟声学不能取代最终实测,但能在结构定型前筛掉明显问题,并生成覆盖更多边界条件的数据。研发团队可以更快比较麦克风位置、阵列方案和算法参数,把实体样机留给最有价值的验证。

从硬件声学连到语音AI
DSP Concepts的Audio Weaver负责算法仿真与实时部署,Treble提供环境与设备的声学模型,两者衔接后,团队可以从“声音怎样进入眼镜”一直看到“算法怎样处理、输出怎样变化”。这对语音唤醒、指令识别、字幕、通话和空间音频尤其重要。
项目验收也应随之升级:除了安静房间识别率,还应覆盖行走、转头、多人说话、不同佩戴者、不同空间和扬声器回放。只要场景库、指标和复现方法在开发初期就确定,后续硬件换型或算法更新便有稳定基线。
视+AR观察
智能眼镜行业正在从“有没有语音功能”进入“复杂环境下是否持续可用”的阶段。视+AR在工业、导览和MR应用中强调完整体验链路:视觉定位稳定、交互反馈及时、语音入口可靠、内容与设备可管理。虚拟声学与合成数据让声学问题更早进入产品工程,也让应用团队能把噪声、移动和多人场景写进需求与验收,而不是上线后再被动修补。
常见问题 FAQ
Treble 3.2主要解决什么?
它用物理声学仿真和合成音频数据,帮助团队更早验证智能眼镜音频与语音方案。
虚拟测试能替代真人和样机测试吗?
不能完全替代,但可扩大场景覆盖并在样机定型前淘汰明显不佳的设计。
为什么要模拟不同佩戴者?
头型、贴合和镜框角度会改变麦克风与声源的相对位置,进而影响采音。
哪些功能最受益?
语音唤醒、实时字幕、翻译、远程协作、通话降噪和空间音频。
行业项目怎样写验收项?
把移动、转头、多人、风噪、混响和不同佩戴方式纳入可复现的场景矩阵。